Metadata & AI Tag là gì? Vì sao nội dung AI ngày càng bị gắn nhãn?
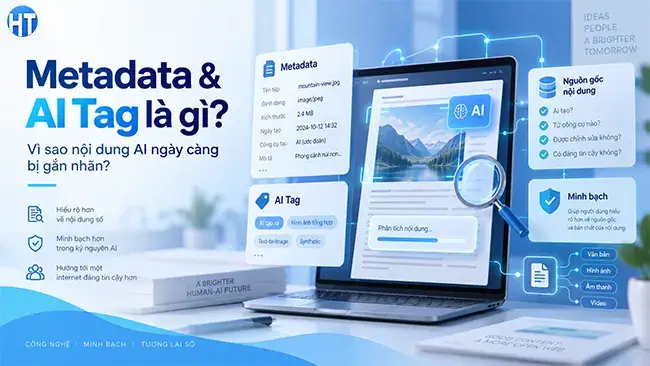
Nếu thường xuyên sử dụng các công cụ AI để tạo ảnh, video hoặc nội dung trong thời gian gần đây, có thể bạn đã bắt đầu để ý một điều khá thú vị: file tải về đôi khi không còn “sạch” theo nghĩa chỉ chứa mỗi hình ảnh hay video nữa.
Bên trong file có thể xuất hiện thêm metadata liên quan đến AI. Khi đăng lên Facebook, Instagram hoặc một số nền tảng khác, nội dung đôi khi còn xuất hiện nhãn như “AI info”, “AI-generated” hoặc một thông báo tương tự.
Ban đầu mình cũng nghĩ đây đơn giản chỉ là cách các công ty AI tự đánh dấu sản phẩm của họ. Nhưng tìm hiểu kỹ hơn thì câu chuyện rộng hơn khá nhiều.
Nó liên quan đến một vấn đề mà Internet đang phải giải quyết: khi AI có thể tạo ra hình ảnh, giọng nói và video giống thật đến mức con người khó phân biệt, làm thế nào chúng ta biết một nội dung đến từ đâu?
Metadata thực ra không phải thứ mới xuất hiện cùng AI
Metadata có thể hiểu đơn giản là dữ liệu mô tả về một dữ liệu khác.
Ví dụ, một bức ảnh chụp từ điện thoại có thể chứa thông tin về thời gian chụp, thiết bị sử dụng, kích thước ảnh hoặc các thông số máy ảnh. Một file tài liệu cũng có thể chứa thông tin về phần mềm tạo file, thời điểm chỉnh sửa hoặc tác giả.
Những thứ đó đã tồn tại từ rất lâu trước khi AI tạo sinh trở nên phổ biến.
Điểm khác biệt hiện nay là các công ty bắt đầu sử dụng metadata để ghi thêm nguồn gốc của nội dung. Chẳng hạn một file có thể chứa thông tin cho biết nội dung được tạo hoặc chỉnh sửa bằng một công cụ AI nhất định.
Một trong những tiêu chuẩn đang được nhắc đến nhiều là C2PA – Coalition for Content Provenance and Authenticity. C2PA xây dựng chuẩn Content Credentials để ghi lại nguồn gốc và lịch sử của nội dung số theo cách có thể xác minh bằng chữ ký mật mã. Thông tin đó có thể cho biết nội dung được tạo bằng công cụ nào, trải qua những bước chỉnh sửa nào hoặc nguồn gốc ban đầu của file.
Nếu giải thích thật đơn giản thì Content Credentials hơi giống một dạng “hộ chiếu của file”.
Nó không nói bức ảnh đẹp hay xấu, đúng hay sai. Nó chỉ cố gắng trả lời câu hỏi: “Thứ này được tạo ra như thế nào?”
AI Tag lại là một chuyện hơi khác
Metadata thường nằm bên trong file và người dùng bình thường có thể không nhìn thấy.
Còn AI Tag là thứ nền tảng chủ động hiển thị ra ngoài để người xem dễ nhận biết hơn.
Ví dụ Meta hiện sử dụng nhãn “AI info” trên Facebook và Instagram đối với một số nội dung mà hệ thống xác định có liên quan đến AI. Nhãn này có thể xuất hiện dựa trên các tín hiệu kỹ thuật được chia sẻ giữa các công ty hoặc do chính người đăng khai báo rằng nội dung được tạo hay chỉnh sửa bằng AI.
Điều này có nghĩa metadata và AI Tag có liên quan nhưng không phải là một.
Metadata nằm trong hoặc đi kèm nội dung.
AI Tag là cách một nền tảng diễn giải những tín hiệu đó cho người sử dụng.
Ví dụ một bức ảnh có thể chứa thông tin cho biết nó được tạo bằng công cụ AI. Khi Facebook đọc được tín hiệu phù hợp, Facebook có thể hiển thị nhãn AI cho người xem.
Ngoài Metadata còn có một thứ khó nhìn thấy hơn: Watermark AI
Nếu chỉ dựa vào metadata thì có một vấn đề khá rõ ràng.
Metadata có thể biến mất.
Khi một hình ảnh được chuyển đổi định dạng, chỉnh sửa qua một phần mềm khác, chụp màn hình hoặc được một nền tảng xử lý lại, một phần metadata có thể bị loại bỏ.
Google vì vậy phát triển SynthID, một dạng watermark kỹ thuật số được nhúng trực tiếp vào nội dung. Với hình ảnh và video, tín hiệu có thể được đưa vào chính dữ liệu hình ảnh; với âm thanh thì được nhúng theo cách người nghe không nhận ra; Google cũng đã phát triển SynthID cho văn bản AI.
Khác với logo chìm mà chúng ta nhìn thấy ở góc ảnh, dạng watermark này có thể không nhìn thấy bằng mắt thường.
Google cho biết SynthID được thiết kế để vẫn có khả năng phát hiện sau một số thao tác phổ biến như crop, thêm filter hoặc nén file, dù bản thân Google cũng nói rõ đây không phải một giải pháp hoàn hảo trong mọi trường hợp.
OpenAI hiện cũng sử dụng nhiều tín hiệu nguồn gốc cho một số nội dung được hỗ trợ. Theo tài liệu của OpenAI, hình ảnh được hỗ trợ có thể chứa cả Content Credentials theo chuẩn C2PA và watermark SynthID, trong khi một số nội dung âm thanh sử dụng SynthID.
Điều mình thấy đáng chú ý là ngành AI đang không đặt cược hoàn toàn vào một phương pháp duy nhất.
Metadata cung cấp nhiều thông tin.
Watermark giúp tín hiệu khó biến mất hơn.
Còn AI Tag giúp người bình thường hiểu những tín hiệu đó mà không cần mở file ra kiểm tra kỹ thuật.
Tại sao trước đây không cần mà bây giờ lại cần?
Câu trả lời đơn giản nhất theo mình là:
Vì AI đã bắt đầu tạo ra những thứ quá giống thật.
Cách đây vài năm, một bức ảnh AI thường khá dễ nhận biết. Tay có sáu ngón, chữ trên biển hiệu bị méo, khuôn mặt kỳ quặc hoặc các chi tiết trong ảnh không logic.
Bây giờ tình hình đã khác.
Một người chưa từng tồn tại có thể xuất hiện trong một bức ảnh gần giống ảnh chụp.
Một người thật có thể bị đặt vào một hoàn cảnh chưa từng xảy ra.
Giọng nói có thể được tạo giống người thật.
Video ngày càng có thể mô phỏng con người, địa điểm hoặc sự kiện một cách thuyết phục.
Khi khả năng tạo nội dung tăng lên, việc chỉ dựa vào câu hỏi “nhìn có giống AI không?” ngày càng thiếu tin cậy.
Google cũng nói rõ một trong những lý do phát triển SynthID là việc nội dung tổng hợp ngày càng khó phân biệt với nội dung không được tạo bởi AI, kéo theo nguy cơ phát tán thông tin sai lệch hoặc gây nhầm lẫn.
Vì vậy câu chuyện dần chuyển từ:
“Chúng ta có phát hiện được AI bằng mắt không?”
sang:
“File này có mang được bằng chứng về nguồn gốc của nó không?”
Theo mình đây là một hướng hợp lý hơn nhiều.
Nếu là người bình thường không biết về AI thì nên hiểu nhãn AI thế nào?
Đây là phần mình nghĩ quan trọng nhất.
Khi nhìn thấy chữ AI bên dưới một bức ảnh, đừng lập tức hiểu rằng:
“Ảnh này là giả.”
Hai chuyện đó hoàn toàn khác nhau.
Một nhiếp ảnh gia có thể tự chụp một bức ảnh thật rồi dùng AI để xóa một người ở phía sau.
Một designer có thể tạo nền bằng AI nhưng tự thiết kế toàn bộ phần còn lại.
Một nhân viên văn phòng có thể dùng AI để tạo một hình minh họa trong PowerPoint.
Một video thật có thể chỉ sử dụng AI để chỉnh âm thanh.
Tất cả những trường hợp đó đều có thể được coi là nội dung có sự tham gia của AI, nhưng mức độ AI tham gia rất khác nhau.
Adobe mô tả Content Credentials theo hướng này khá rõ: thông tin nguồn gốc có thể cho biết nội dung được chụp bằng máy ảnh, được chỉnh sửa bằng phần mềm hay được tạo bằng AI. Nó không đơn giản chỉ chia thế giới thành hai nhóm “thật” và “AI”.
Vì vậy, khi thấy AI Tag, cách mình nghĩ hợp lý hơn là:
“Có AI tham gia vào quá trình tạo hoặc chỉnh sửa nội dung này.”
Sau đó nếu nội dung quan trọng, đặc biệt là tin tức, bằng chứng hoặc thông tin có khả năng ảnh hưởng đến người khác, chúng ta mới cần kiểm tra thêm nguồn.
Và nếu không có AI Tag thì cũng chưa chắc nội dung đó không phải AI
Đây là điều rất dễ bị hiểu ngược.
AI Tag không phải một hệ thống phát hiện tuyệt đối.
Một file có thể bị mất metadata khi chỉnh sửa.
Một nền tảng có thể chưa hỗ trợ loại tín hiệu đó.
Một công cụ AI khác có thể không gắn Content Credentials.
Người dùng cũng có thể thực hiện các thao tác làm mất một số thông tin nguồn gốc.
Ngay cả OpenAI cũng lưu ý rằng các tín hiệu nguồn gốc chỉ là chỉ dấu hữu ích, chứ không chứng minh nội dung chính xác, chưa bị chỉnh sửa, thuộc quyền sở hữu hợp pháp hoặc đang được đặt đúng ngữ cảnh.
Điều này rất quan trọng.
Có AI Tag không có nghĩa nội dung sai.
Và:
Không có AI Tag cũng không có nghĩa nội dung chắc chắn do con người tạo ra.
Nó chỉ là thêm một lớp thông tin giúp chúng ta đưa ra quyết định tốt hơn.
Không chỉ ảnh, video – nội dung văn phòng cũng bắt đầu đi theo hướng này
Một điều khá thú vị là việc đánh dấu AI đang dần lan ra ngoài các công cụ tạo ảnh.
Microsoft hiện đã triển khai các tùy chọn watermark cho nội dung được tạo hoặc chỉnh sửa bằng AI trong Microsoft 365. Hình ảnh có thể có watermark hiển thị, video có thể xuất hiện nhãn AI và một số nội dung âm thanh thậm chí có thể có thông báo bằng âm thanh rằng nội dung được tạo bởi AI. Microsoft cũng bổ sung thông tin AI vào metadata của một số loại nội dung được tạo hoặc chỉnh sửa bằng Microsoft 365.
Theo mình đây là dấu hiệu cho thấy khái niệm nguồn gốc nội dung sẽ không chỉ dừng ở ảnh.
Trong tương lai, khi một file được tạo ra từ AI, được chỉnh sửa bằng AI, chuyển qua một ứng dụng khác rồi được xuất thành tài liệu, video hoặc nội dung trình chiếu, chúng ta có thể sẽ thấy ngày càng nhiều hệ thống cố gắng giữ lại một phần lịch sử đó.
C2PA thậm chí định nghĩa provenance khá rộng, áp dụng cho nhiều dạng nội dung số, bao gồm hình ảnh, video, âm thanh và tài liệu.
Nếu đứng ở góc độ một người sử dụng AI thường xuyên
Cá nhân mình không thấy việc AI gắn metadata là điều gì quá đáng lo.
Nếu mình tạo một hình ảnh bằng AI thì việc trong file có thông tin rằng nó được tạo bằng AI cũng khá bình thường.
Thậm chí về lâu dài mình nghĩ điều này còn có lợi cho chính người sáng tạo.
Giả sử mình tạo một bức ảnh, chỉnh sửa nó, xuất bản và vài tháng sau một người khác lấy lại. Nếu tồn tại một chuỗi Content Credentials đáng tin cậy, việc xác định nguồn gốc và lịch sử của file có thể rõ ràng hơn so với cách Internet hoạt động hiện nay.
Đặc biệt đối với những người tạo nội dung bằng AI một cách nghiêm túc, provenance có thể trở thành một phần của việc chứng minh quy trình sáng tạo.
Mình cũng không có ý định cố gắng xóa AI metadata chỉ để khiến người khác tưởng nội dung hoàn toàn không sử dụng AI.
Nếu AI là một công cụ trong quy trình của mình thì việc thừa nhận điều đó chẳng có gì đáng xấu hổ.
Cũng giống như một nhiếp ảnh gia sử dụng Photoshop, một editor dùng Premiere hay một lập trình viên sử dụng thư viện của người khác. Quan trọng cuối cùng vẫn là con người đã làm gì với công cụ đó.
Nhưng Metadata cũng đặt ra vấn đề về quyền riêng tư
Ở chiều ngược lại, mình nghĩ người dùng cũng nên hiểu rằng metadata không phải lúc nào cũng vô hại.
Metadata về nguồn gốc nội dung có ích, nhưng một file nói chung còn có thể chứa những thông tin khác mà người dùng không muốn chia sẻ.
Đây là lý do các tiêu chuẩn provenance tốt cần cân bằng giữa tính minh bạch và quyền riêng tư.
Việc chứng minh rằng một bức ảnh được tạo hoặc chỉnh sửa bằng công cụ nào không đồng nghĩa với việc phải công khai toàn bộ danh tính, vị trí hoặc mọi thao tác của người tạo.
C2PA cũng xây dựng tiêu chuẩn theo hướng dữ liệu có chữ ký và có khả năng xác minh, nhưng không có nghĩa mọi thông tin cá nhân đều bắt buộc phải được nhúng vào file.
Theo mình, hướng phát triển đúng nên là:
Minh bạch về nguồn gốc nội dung, nhưng không biến metadata thành công cụ theo dõi người tạo.
AI Tag xuất hiện còn vì luật pháp bắt đầu thay đổi
Một lý do nữa khó tránh khỏi là quy định pháp luật.
Khi AI bắt đầu ảnh hưởng đến quảng cáo, báo chí, chính trị, bản quyền và thông tin trên mạng, nhiều quốc gia bắt đầu yêu cầu doanh nghiệp phải minh bạch hơn đối với nội dung tổng hợp.
Adobe hiện cũng nhắc trực tiếp đến các quy định mới và đang hình thành, bao gồm EU AI Act và một số luật minh bạch AI, như một trong những lý do ngành công nghệ cần phát triển cơ chế gắn nhãn nội dung AI.
Meta trong năm 2026 cũng tiếp tục tham gia các sáng kiến về minh bạch nội dung AI và làm việc với C2PA cùng các bên khác để phát triển những phương pháp nhận diện nội dung tổng hợp có khả năng hoạt động xuyên nền tảng.
Nói cách khác, AI Tag không đơn thuần là một tính năng trang trí.
Nó đang dần trở thành một phần của hạ tầng niềm tin trên Internet.
Theo mình, đây là điều sớm muộn cũng phải xảy ra
Trong thời kỳ Internet trước AI, khi nhìn thấy một bức ảnh, phản xạ của chúng ta thường là nghĩ rằng có một chiếc máy ảnh đã chụp nó.
Bây giờ giả định đó không còn đúng nữa.
Một bức ảnh có thể được chụp.
Có thể được chỉnh sửa.
Có thể được AI tạo hoàn toàn.
Hoặc có thể là sự kết hợp của cả ba.
Video và âm thanh cũng đang đi theo con đường tương tự.
Vì vậy chúng ta cần một cách mới để nói về nguồn gốc nội dung. Metadata, Content Credentials, watermark như SynthID và AI Tag hiện tại là những bước đầu tiên để giải quyết vấn đề đó.
Chúng chắc chắn chưa hoàn hảo. Metadata có thể bị mất, watermark không phải lúc nào cũng phát hiện được và AI Tag cũng có thể khiến người dùng hiểu nhầm nếu được thiết kế không tốt.
Nhưng mình nghĩ hướng đi là đúng.
Trong tương lai, có lẽ câu hỏi quan trọng sẽ không còn là:
“Đây có phải AI không?”
mà sẽ là:
“Nội dung này được tạo ra như thế nào, ai tạo ra nó và mình có thể tin vào nguồn gốc của nó đến mức nào?”
Và khi AI ngày càng trở thành một công cụ bình thường giống như Photoshop, camera hay phần mềm dựng phim, mình nghĩ đó mới là câu hỏi thực sự đáng quan tâm.